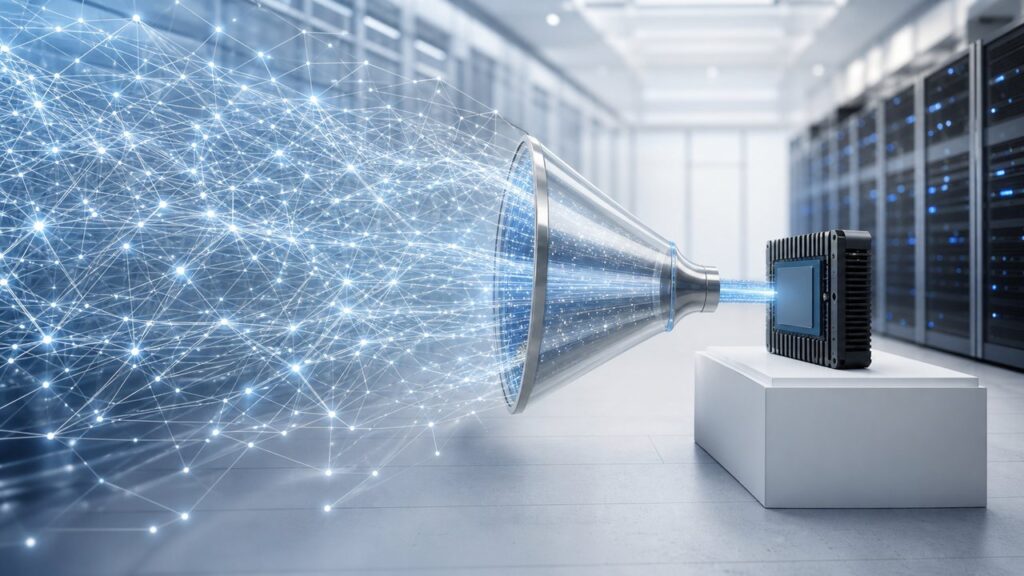
Streszczenie wykonawcze: Nowoczesne modele AI można znacząco zoptymalizować technikami kompresji i dostrajania. „Destylacja wiedzy” (knowledge distillation) pozwala przenieść moc dużego modelu („nauczyciela”) do znacznie mniejszego modelu („ucznia”). Podobnie przycinanie (pruning) usuwa nadmiarowe połączenia sieci, a kwantyzacja obniża precyzję reprezentacji wag (np. 16-bit → 8-bit) w celu zaoszczędzenia pamięci. Dostrajanie (fine-tuning) i uczenie transferowe pozwalają zaadaptować ogólny model do konkretnego zadania czy domeny przy użyciu mniejszej ilości danych. Nowe metody efektywnego dostrajania, jak LoRA (Low-Rank Adaptation) czy adaptery, dodają niewielkie moduły do zamrożonego modelu bazowego, co pozwala na szybkie „douczenie” go bez zmiany wszystkich parametrów. Te techniki pozwalają małym, lokalnym modelom osiągać wydajność porównywalną z dużymi systemami przy znacznie niższych kosztach obliczeniowych. Poniższy raport w przystępny sposób omawia definicje, porównuje metody, podaje praktyczne wskazówki krok po kroku oraz przykłady polskich i chińskich wdrożeń (modele PLLuM, DeepSeek, GLM itp.).
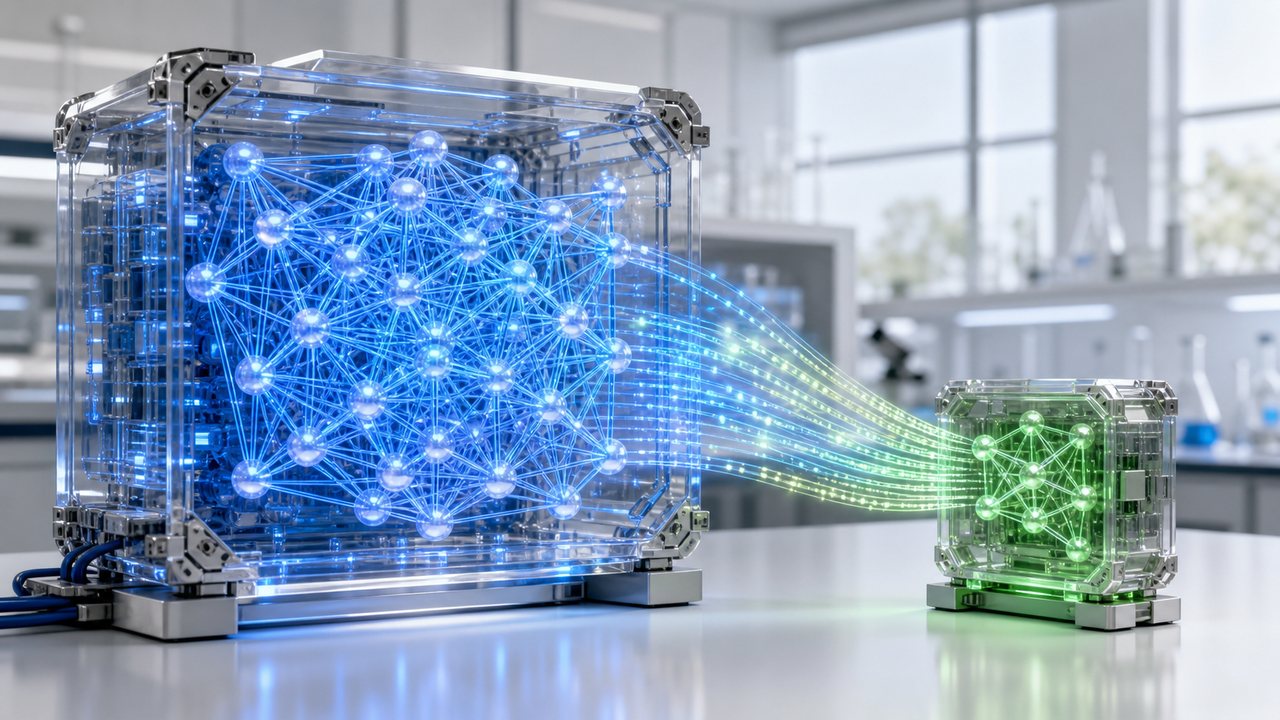
Kluczowe pojęcia i definicje
- Destylacja wiedzy (Knowledge Distillation) – proces, w którym duży, wydajny model (nauczyciel) uczy mniejszy model (uczeń) swoich prognoz (tzw. „miękkich etykiet”). Dzięki temu mały model przejmuje część zdolności nauczyciela, zachowując wysoką dokładność przy mniejszych wymiarach. Daje to modeli aż 1–2 rzędy wielkości mniej parametrów i szybsze wnioski kosztem nieznacznego spadku jakości.
- Przycinanie (Pruning) – usuwanie zbędnych wag w sieci neuronowej (np. tych bliskich zero lub o małym znaczeniu). Pozwala to na zmniejszenie architektury modelu oraz jego wymagań obliczeniowych. Zaletą jest mniejszy model; wadą – proces przycinania wymaga ponownego treningu i może obniżyć dokładność, jeśli nie zostanie starannie wykonany.
- Kwantyzacja (Quantization) – redukcja precyzji liczb (np. z 16-bit do 8-bit lub nawet 4-bit) reprezentujących wagi i aktywacje sieci. Mniejsza precyzja „odchudza” model, co umożliwia jego uruchamianie na słabszym sprzęcie (CPU, mobilnym) i obniża zużycie pamięci oraz energii. Przy prawidłowym doborze formatów spadek jakości jest minimalny. Przykładem jest skwantyzowany model GPT, który odpowiada mniej precyzyjnie, ale szybciej i taniej.
- Dostrajanie (Fine-tuning) – dalszy trening dużego modelu na wąskiej domenie lub konkretnym zadaniu (z mniejszym, specyficznym zbiorem danych). Pozwala wykorzystać istniejącą wiedzę modelu i przyspieszyć rozwój rozwiązania, jednocześnie poprawiając precyzję w danej dziedzinie. Wymaga umiarkowanie więcej obliczeń (ale znacznie mniej niż trenowanie od zera) i dobrze zbalansowanej próbki danych, by uniknąć nadmiernego dostosowania do małego zbioru.
- Uczenie transferowe (Transfer learning) – wykorzystanie wcześniej wytrenowanego modelu jako punktu startowego dla nowego zadania. Zamiast trenować od początku, „przerabia się” gotowy model (np. BERT, GPT) na nowy problem, dodając np. nowe warstwy klasyfikatora lub częściowo dostrajając istniejące. Pozwala to szybko osiągać dobre wyniki przy niewielu danych.
- Adaptery (AI Adapter) – lekkie moduły (dodatkowe warstwy) wprowadzane między warstwy modelu bazowego (np. transformera), których zadaniem jest nauczyć model informacji specyficznych dla nowego zadania. Rdzeń modelu pozostaje zamrożony, uczą się tylko dodatkowe parametry adapterów. Dzięki temu można współdzielić model bazowy i dodawać różne adaptery do różnych zadań czy domen. Adaptery pozwalają uzyskać wyniki porównywalne z pełnym dostrajaniem, trenując tylko kilka procent dodatkowych parametrów.
- LoRA (Low-Rank Adaptation) – wariant metody efektywnego dostrajania, w którym zamiast klasycznych warstw adapterowych wstrzykuje się do istniejących wag małe macierze niskiego rzędu. LoRA „zamraża” wagi bazowe i uczy jedynie niskowymiarowe poprawki, co radykalnie zmniejsza liczbę trenowanych parametrów (nawet o kilka rzędów wielkości) przy niewielkiej utracie jakości. Biblioteka Hugging Face PEFT udostępnia implementację LoRA, która pozwala zaadaptować duże modele na zwykłym sprzęcie konsumenckim.
Porównanie metod kompresji i dostrajania
| Metoda | Cel / zastosowanie | Zalety | Wady | Koszt obliczeniowy | Wymagania danych |
|---|---|---|---|---|---|
| Destylacja | Kompresja dużego modelu do małego ucznia | Bardzo mniejszy model, niższe wymagania pamięci i obliczeń | Dłuższy proces treningu (trzeba trenować ucznia); możliwy spadek dokładności, jeśli model jest zbyt mały | Wysoki (trzeba uruchomić obu modeli) | Dużo – zwykle ogromny zbiór danych lub generowanie etykiet przez nauczyciela |
| Przycinanie | Usunięcie zbędnych wag z sieci | Zmniejsza rozmiar modelu i przyspiesza inferencję | Trzeba ponownie trenować; zbyt agresywne obcięcie pogarsza wyniki | Średni/wysoki (potrzebny retraining) | Danych treningowych koniecznych do drobnej optymalizacji po przycięciu |
| Kwantyzacja | Redukcja bitów wag i operacji | Drastyczna oszczędność pamięci, możliwość uruchomienia na CPU/mobilnych | Może obniżyć jakość (zwłaszcza przy bardzo niskich bitach); problemy ze zgodnością formatów | Niski (stosunkowo prosta transformacja) | Właściwie brak – trzeba tylko sprawdzić jakość po kwantyzacji (testy) |
| Fine-tuning | Dostosowanie modelu do zadania | Zwykle najlepsze wyniki w zadaniu specyficznym przy relatywnie małym nakładzie | Ryzyko przeuczenia na małym zbiorze; wymaga zasobów GPU przy dużych modelach | Średni (trening całych lub wielu warstw modelu) | Średni (specyficzne dane z zadania) |
| Transfer learning | Adaptacja gotowego modelu do nowego zadania | Szybkie wdrożenie na podstawie mocnego modelu bazowego; mniejsze koszty niż od zera | Może wymagać dostrajania modelu, jeśli domena silnie różna | Średni (często tylko dodatkowe warstwy lub selektywne warstwy) | Średni (ogólne dane + niewielki zestaw specyficzny) |
| LoRA / Adaptery | Efektywne dostrajanie dużych modeli | Bardzo mało dodatkowych parametrów; można równocześnie korzystać z wielu adapterów do różnych zadań; niższe zużycie pamięci i GPU | Mniej elastyczne niż pełne fine-tuning (część wagi bazowej nie zmieniana); wymaga integracji modułów (PEFT) | Niski (trenują się tylko moduły adapterów/LoRA) | Średni (dane zadaniowe/instrukcje, podobnie jak przy fine-tuning) |
Tabela: Zestawienie metod optymalizacji i adaptacji modeli AI. Poszczególne podejścia różnią się nakładem obliczeniowym i potrzebami danych, ale wszystkie umożliwiają zmniejszenie modelu lub jego dostosowanie do nowych warunków.
Praktyczne wskazówki krok po kroku
- Określ cel i zasoby. Zastanów się, do czego potrzebny jest model (np. chatbot na stronie, klasyfikator tekstu, wyszukiwarka wektorowa). Oceń, jakie dane masz do dyspozycji (dokumenty firmowe, czatówka, itp.) oraz jaki sprzęt planujesz użyć. To pomoże zdecydować, czy lepiej zacząć od istniejącego modelu czy trenować „od nowa”.
- Wybierz lub pozyskaj bazowy model. Skorzystaj z otwartych repozytoriów (Hugging Face, GitHub). W Polsce dobrym startem jest PLLuM – polski, otwartoźródłowy LLM dostępny w różnych rozmiarach (8B, 12B, 70B) na licencjach Apache 2.0 lub llama3.1. W Chinach popularne są modele takie jak Alibaba Qwen, Zhipu GLM czy DeepSeek (kod źródłowy na GitHubie). Upewnij się, że licencja pozwala na twoje zastosowanie (np. komercyjne vs niekomercyjne).
- Użyj gotowych narzędzi do kompresji. Jeśli potrzebujesz model na słabszym sprzęcie, zastosuj kwantyzację i pruning. Biblioteki takie jak Transformers (Hugging Face) oferują Optimum z modułami do kwantyzacji (np. Intel Neural Compressor) czy narzędzia bitsandbytes do szybkiej konwersji do 8-bit. W przypadku LLM warto rozważyć QLoRA – połączenie kwantyzacji z LoRA, zmniejszające model nawet do 4-bit i umożliwiające dalsze fine-tuning. Przykładowo model GPT-3 można uruchomić lokalnie, redukując 175 mld parametrów do ~18 mln trenowalnych (LoRA) i 8-bit ogólnej precyzji.
- Dostrój model do zadania. Zbierz specjalistyczny zestaw danych lub instrukcji (promptów) związanych z Twoim zastosowaniem. Użyj technik fine-tuningu lub PEFT (adaptery/LoRA). Hugging Face udostępnia bibliotekę PEFT, która umożliwia szybkie „dokowanie” adapterów lub LoRA do każdego transformera. Na przykład w środowisku Python wystarczy kilka linijek z PEFT, by dopasować model do własnych opisów czy kontekstu branży. Firmy mogą też skorzystać z chmurowych serwisów (AWS Sagemaker, Google Vertex AI), które oferują narzędzia do fine-tuningu bez głębokiej wiedzy programistycznej.
- Testuj i optymalizuj. Po zmianach sprawdź jakość modelu na walidacyjnym zestawie danych. Jeśli jakość spadła, spróbuj mniej agresywnej kwantyzacji albo pruned więcej warstw stopniowo. Monitoruj szybkość odpowiedzi i zużycie zasobów. Wykorzystaj mechanizmy RAG (Retrieval-Augmented Generation) – połącz mały model z wewnętrzną bazą dokumentów, by zwiększyć dokładność odpowiedzi (model korzysta z aktualnych danych, a nie tylko własnej pamięci).
- Wdrożenie i serwis. Zdecyduj, gdzie i jak uruchomisz model (lokalnie vs chmura). Polskie modele PLLuM działają na zwykłym GPU – mniejsze wersje (4–8B) można uruchomić nawet na pojedynczej karcie graficznej, większe wymagają wydajniejszych maszyn (np. serwerów z NVIDIA A100). Zadbaj o monitoring, aktualizacje danych i retrening adapterów lub modelu, jeśli domena się zmienia.
- Bezpieczeństwo i etyka. Wybieraj dane do treningu zgodne z prawem (licencje, RODO). Polskie projekty podkreślają etyczne pozyskiwanie danych – PLLuM używa wyłącznie licencjonowanych i dozwolonych zbiorów. Upewnij się, że model nie generuje treści obraźliwych ani nieprawdziwych (testuj na przykładach skrajnych). W Chinach modele często podlegają cenzurze i filtrom (np. DeepSeek blokuje krytykę władz) – znając lokalne przepisy, unikaj kontrowersyjnych treści.
Studia przypadków: Chiny i Polska
- Chiny – masowy rozwój i optymalizacja: Chiny inwestują w własne LLM jako sprawę strategiczną. Firmy takie jak Zhipu AI (GLM-5) czy startup DeepSeek regularnie pokazują, że dzięki inżynierii (MoE, kwantyzacja, destylacja) można uzyskać modele bliskie jakości światowych liderów za ułamek kosztów. DeepSeek-V3 (671 mld param.) wykorzystuje architekturę MoE i proces distillation z poprzedniej generacji R1, by skompilować wiedzę długiego Chain-of-Thought do bardziej kompaktowego modelu. Podobnie Zhipu GLM-5.2 osiąga wydajność zbliżoną do amerykańskich modeli (Claude 4.5) przy aktywacji tylko ~40 mld parametrów na zapytanie. Chiny rozważają obecnie ograniczenia eksportu swoich najnowszych modeli (wydania zamknięte i open source) oraz wprowadzenie surowych kar za kradzież AI. Dzięki takim inicjatywom i niskim kosztom (np. GLM-5 za ok. 0,80$ za milion tokenów), chińskie modele – np. Alibaba Qwen, ByteDance Doubao, Zhipu GLM – zaczynają dominować rynek jako tanie „komodity” AI. Jednocześnie rząd naciska na ochronę danych i cenzurę treści (deepseek filtruje krytykę polityczną), co stanowi istotny kontekst prawny i etyczny ich rozwoju. Repozytoria takie jak DeepSeek GitHub i platformy open-source (np. Open-R1 na HF) umożliwiają społeczności analizę tych modeli.
- Polska – suwerenność cyfrowa i współpraca naukowa: Polska również rozwija własne LLM. Flagowym przykładem jest PLLuM – projekt rządowy konsorcjum uczelni i instytutów (NASK, PAN, UŁ itp.). PLLuM to rodzina 18 modeli (8–70 mld parametrów) specjalizowanych w języku polskim. Dzięki podejściu Mixture of Experts oraz modelom RAG uzyskuje się wersje „niskonakładowe” (8B) do szybkich zadań i duże (70B) dla wysokiej precyzji. Modele PLLuM są udostępnione na Hugging Face w przestrzeni organizacji CYFRAGOVPL, z licencjami Apache 2.0 lub llama3.1 dla komercji oraz wersjami non-commercial. Dane treningowe pochodzą w większości z legalnych źródeł (materiały otwarte, licencjonowane przez konsorcjum) – co zapewnia zgodność z prawem autorskim i etykę. Dodatkowo, proces trenowania obejmował setki tysięcy prompts i ocen preferencji budowane przez zespół ekspertów (~50 osób). W Polsce narzędzia takie jak PLLuM ułatwiają dostęp – gotowe modele można pobrać z Hugging Face i uruchomić lokalnie. Ponadto budowany jest ekosystem (projekt HIVE), którego celem jest dalszy rozwój modeli w różnych instytucjach (np. Cyfronet AGH dostarcza superkomputer Helios do obliczeń). Przykładowe zastosowania to chatboty w urzędach (mObywatel), asystenci dla urzędników czy systemy wyszukiwania w dokumentach. Polski wkład skupia się na dopasowaniu modeli do polskich realiów językowych – PLLuM świetnie radzi sobie z fleksją i terminologią administracyjną dzięki treningowi na rodzimych zasobach.
Narzędzia i zasoby
- Repozytoria i dokumentacja: Modele i biblioteki są publicznie dostępne. Źródła: Hugging Face (organizacja CYFRAGOVPL z modelami PLLuM), GitHub (np. deepseek-ai/deepseek-v3, PEFT – narzędzia do adapterów/LoRA). Publikacje: Hinton “Distilling the Knowledge…” (2015) wprowadza destylację, Hu et al. “LoRA: Low-Rank Adaptation…” (2021) opisuje LoRA, pracę Houlsby’ego z 2019 pokazuje adaptery dla transformatorów. Oficjalne blogi (np. IBM [“What is LoRA?”], Hugging Face docs [PEFT]) podają przystępne wyjaśnienia.
- Przykładowe narzędzia:
- Hugging Face Transformers – biblioteka udostępniająca gotowe modele (BERT, GPT, Llama itp.) i mechanizmy fine-tuningu.
- 🤗 PEFT – biblioteka Hugging Face do efektywnego dostrajania, obsługująca adaptery, LoRA itp..
- Optimum (Intel) – rozszerzenie Transformers zawierające moduły do kwantyzacji i przycinania.
- BitsAndBytes – narzędzie do 8-bitowego treningu i inferencji LLM.
- LightLLM (RACE) – zoptymalizowany silnik dla skwantyzowanych modeli, np. dla DeepSeek.
- Hugging Face Spaces / API – umożliwiają wdrożenie modelu jako usługi webowej.
- Google Vertex AI, AWS Sagemaker – komercyjne platformy z obsługą treningu i optymalizacji LLM.
- Ray/Rayserve, Nvidia Triton – rozwiązania do skalowania inferencji modelu w produkcji.
- Zastosowania praktyczne: Wiele firm i instytucji oferuje usługi wsparcia: przykładowo Commint (PL) w swoich bazach wiedzy opisuje definicje i porównania metod AI. Gotowe implementacje można znaleźć jako case studies – np. repozytorium PLLuM zawiera przykłady promptów i instrukcje wdrożenia. Schemat kroków wdrożenia (definiowanie potrzeb, przygotowanie danych, instancja sprzętowa, instalacja) przedstawiono na stronie PLLuM.
Tabela porównawcza metod i narzędzi
| Metoda / Narzędzie | Cel / zastosowanie | Główne zalety | Główne wady / ograniczenia |
|---|---|---|---|
| Knowledge Distillation | Kompresja dużego modelu do mniejszego (Student ← Teacher) | Znacząco mniejszy model przy zachowaniu dobrej jakości; niższe opóźnienia inferencji | Proces wymagający ponownego treningu i danych uczących od nauczyciela; ryzyko utraty precyzji przy zbyt małym modelu |
| Model Pruning | Redukcja liczby wag w sieci | Pomniejszenie architektury, przyspieszenie działania modelu; kompatybilny z istniejącą architekturą | Wymaga przetrenowania po przycięciu; nadmierne przycięcie może obniżyć dokładność |
| Quantization | Obniżenie bitowej precyzji wag/aktywacji | Drastyczna redukcja pamięci i zasobów (np. uruchomienie na CPU) | Spadek jakości odpowiedzi przy zbyt agresywnej kwantyzacji; wymaga walidacji wyników |
| Fine-tuning | Dostosowanie modelu do konkretnego zadania | Najwyższa precyzja dla specyficznych zastosowań; wykorzystanie mniejszej ilości danych niż trenowanie od zera | Kosztowny przy bardzo dużych modelach; ryzyko overfittingu przy małym zbiorze danych |
| Transfer Learning | Adaptacja modelu ogólnego do nowej domeny | Szybkie wdrożenie na bazie silnego modelu; oszczędność danych treningowych i czasu | Mniejsze korzyści, jeśli domena różni się znacząco od danych bazowych |
| Adaptery / LoRA | Parametrycznie efektywne dostrajanie | Pozwala dodać nowe umiejętności modelowi (różne zadania lub języki) z minimalnymi dodatk. parametrami | Nie zmienia wszystkich wag – może nie osiągnąć pełnej elastyczności; wymaga specjalnej implementacji (biblioteki PEFT) |
| Retrieval-Augmented Generation (RAG) | Połączenie modelu LLM z bazą wiedzy | Zwiększa trafność odpowiedzi przez korzystanie z zewn. danych; nie wymaga retreningu modelu bazowego | Wymaga wydajnego systemu wyszukiwania wektorowego; dodatkowa złożoność architektury |
Diagramy
nauczyciel
uczeń
Rys. Schemat destylacji wiedzy: uczeń uczy się od nauczyciela poprzez dopasowanie miękkich etykiet i utrzymuje zwartość struktury. Po skonstruowaniu ucznia jest on wykorzystywany do szybszego działania systemu.
Rys. Zarys chronologii rozwoju technik modelowania: od klasycznej destylacji przez adaptery i LoRA, aż po obecne biblioteki PEFT. Pokazuje to, że obecny trend to parametrowo efektywne dostrajanie dużych modeli do konkretnych zadań.
Źródła i dodatkowe materiały
- Commint, Baza wiedzy AI – definicje: destylacja (destylacja węczynia AI), pruning (przycinanie), fine-tuning (dostrajanie), transfer learning, adaptery.
- IBM – What is LoRA? (2024) – omówienie techniki LoRA i jej zalet.
- AIholics – hasło Kwantyzacja (Quantization) – polska definicja i przykłady scenariuszy zastosowania.
- Janusz Chustecki (Computerworld.pl) – artykuł Kwantyzacja modeli AI (2024) – wyjaśnienie procesu kwantyzacji dla modeli językowych na urządzeniach o niskich zasobach.
- Huang et al., LoRA: Low-Rank Adaptation of LLMs (ArXiv 2021).
- Hu et al., Rethinking Knowledge Distillation (ArXiv 2022).
- GitHub DeepSeek – oficjalne repozytorium DeepSeek-V3 (Chiny).
- Reuters (2026) – Curbing overseas access to China’s top AI models – opis chińskiej polityki i modeli (DeepSeek, GLM-5.2, Qwen, Doubao).
- ITwiz.pl (2025) – artykuł Rząd udostępnia polski model PLLuM – informacje o konsorcjum, licencjach, wielkości modelu (8–70 mld), architekturze MoE i RAG.
- Hugging Face – organizacja CYFRAGOVPL (Modele PLLuM), biblioteka PEFT (dokumentacja).
- Merkur Technology Solutions (2026) – blog The “Temu-fication” of AI: GLM-5 – analiza ceny wydajności GLM-5 dzięki distylacji.
Powyższe źródła (artykuły, dokumentacja, repozytoria) zawierają szczegółowe opisy omawianych technologii i przykładów. Dzięki nim czytelnik może zgłębić każde z pojęć – od definicji po praktyczne implementacje.